

讀書筆記
一百年前的統計革命如何解釋今天的生活
你打開手機,演算法給你推了一則廣告。你剛才不過在某個購物網站上多看了兩眼一款咖啡機,現在不管滑到哪個平台,咖啡機的廣告都如影隨形。你大概知道這背後是「大數據」和「演算法」在運作,是這個時代最時髦的技術。
但你可能不知道的是,支撐這一切的底層邏輯,是一百年前一群英國人在喝下午茶時吵出來的。
這聽起來有點荒謬。大數據、A/B測試、推薦演算法、數據驅動決策,這些詞聽上去都是二十一世紀的產物,跟劍橋大學的下午茶能有什麼關係?
關係大了。我們要說的這本書叫《女士品茶》,作者是美國統計學家戴維·薩爾斯伯格(David Salsburg)。這本書在統計學領域的地位,相當於哲學界的《蘇菲的世界》,是一本不講公式、只講故事和思想的統計學科普經典。2025年二月,九州出版社(後浪出品)出版了新的中文版。
書名來自一個真實的故事。1920年代末某個夏日的午後,英國劍橋,一群大學教員和他們的太太在花園裡喝下午茶。其中一位女士突然說:把茶倒進牛奶裡,和把牛奶倒進茶裡,味道是不同的。在座的科學家們嗤之以鼻,兩種液體混合之後的化學成分明明一模一樣,能有什麼區別?
但有一位又瘦又矮、戴著厚眼鏡、留著尖髯的男子表情嚴肅起來。他叫羅納德·費希爾(Ronald Aylmer Fisher),後來被封為費希爾爵士。他說:「讓我們來檢驗這個命題吧。」
費希爾設計了一個實驗:準備八杯茶,四杯先加茶後加奶,四杯先加奶後加茶,隨機排序,讓那位女士逐一品嚐並判斷每杯茶是哪種做法。這個實驗的精妙之處不在於那位女士最後答對了幾杯,而在於費希爾怎麼設計它:用多少杯茶才夠?怎麼排除她蒙對的可能?如果她全答對了,我們有多大把握說她真的能分辨,而不是運氣好?
這些問題,翻譯成今天的語言,就是A/B測試的核心邏輯。
你在網路上看到的每一個廣告,背後可能都跑過幾十輪A/B測試。工程師把用戶隨機分成兩組,一組看到A版本的按鈕,一組看到B版本,然後比較哪一組的點擊率更高。這跟費希爾讓那位女士喝八杯茶,本質上是同一件事:用有限的樣本,判斷一個結論可不可信。
大數據時代的「新方法」,骨子裡是百年前的老革命。而這場革命改變的,遠不止是廣告點擊率。
要理解這場革命到底革了什麼命,得先回到19世紀末的科學世界觀。那時候科學家們信奉的是「機械宇宙」:一切自然現象都有因果法則,只要公式夠精確、測量夠準確,理論上可以預測任何事物的未來。拿破崙問拉普拉斯「為什麼你的書裡沒有提到上帝」,拉普拉斯回答「我不需要那個假設」。他相信只要有一組完整的公式和足夠精確的數據,就能算出行星和彗星的未來位置。
1895年,英國統計學家卡爾·皮爾遜(Karl Pearson)把這套世界觀掀翻了。他第一次明確提出:實驗數據的隨機性不是誤差,而是事物本身的固有屬性。所有觀測值都可能符合某種概率分布,科學的目的不是研究某個具體數值,而是發現這種分布的規律性。
世界是一片概率的海洋,你量不出「真正的值」,因為「真正的值」不存在,存在的只有一個分布。這是思想史上的一次地震。
但皮爾遜打開了門,真正把方法論建立起來的,是費希爾。
費希爾最了不起的發明,是一種全新的思考方式:假設檢驗。它的邏輯說穿了很簡單,但威力極大。你先假設「沒有效果」,這叫零假設。新藥無效,兩種茶味道一樣,兩組數據沒有差異。然後你用實驗數據去試圖推翻它。如果零假設成立,觀測到這種結果的概率非常低,那你就拒絕零假設。
關鍵在於最後一步:你永遠不能「證實」零假設,只能推翻它。書中轉述費希爾的觀點:「僅僅因為一個假設與現有事實不矛盾就相信它得到證明的做法存在邏輯錯誤。」
這是一種非常克制的態度。經濟學家何帆用過一個生動的比喻:零假設好比你抓到一個犯罪嫌疑人,但你不能先假設他有罪,你要先假設他是無辜的。你找證據去推翻這個無辜假設,找不到就放人。
統計學要教你的,是判斷一個數字能不能信。這才是它的核心精神。算數只是手段,懷疑才是目的。一種有方法的、有紀律的懷疑。
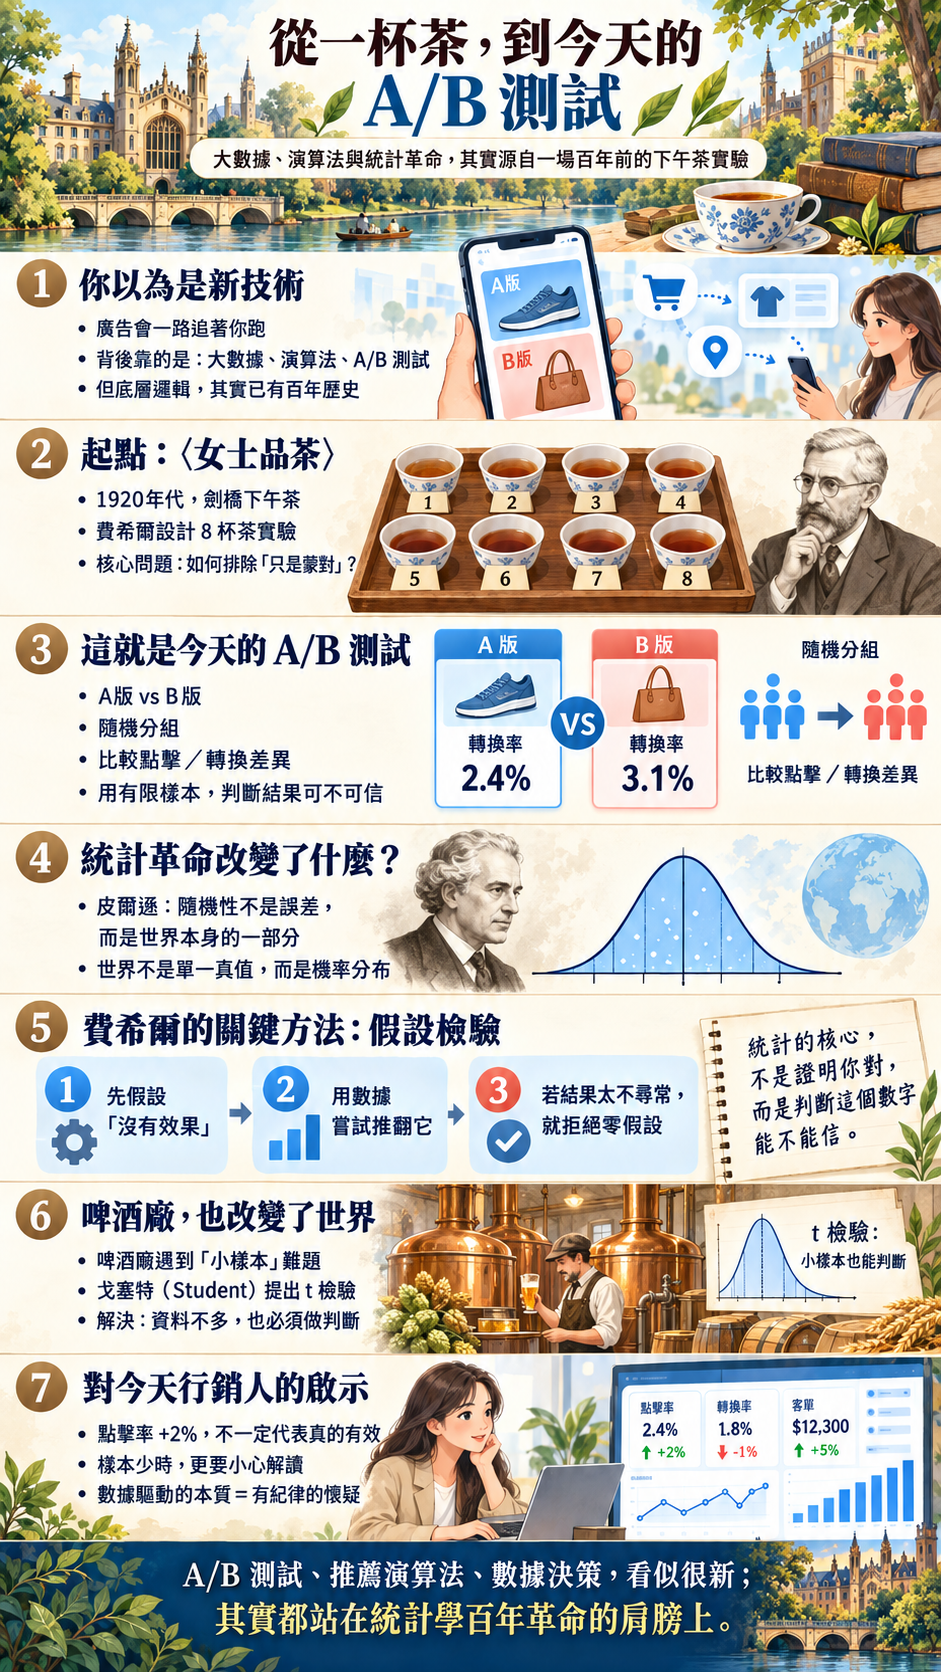
1899年,愛爾蘭的吉尼斯(Guinness)啤酒廠做了一個決定:僱用大學化學畢業生,把現代科學方法引進企業。23歲的威廉·戈塞特(William Sealy Gosset)就這樣進了公司。公司看重的是他的化學知識。啤酒廠要數學家有什麼用呢?
但恰恰是數學救了啤酒。發酵需要嚴格控制酵母用量,放少了發酵不充分,放多了啤酒變苦。工人從罐中取樣,在顯微鏡下數酵母細胞,但數出來的數字每次都不一樣,怎麼辦?戈塞特就是在這裡用上了數學。他發現酵母細胞的數量呈現一種可預測的規律,據此設計出更精準的測量方法,大大提高了產品穩定性。
但他遇到一個更大的難題。皮爾遜的統計方法需要大樣本,動輒數千次測量。可啤酒廠的實驗往往只有十來個觀測值。小樣本怎麼辦?
戈塞特每天晚上坐在餐桌前,手工收集小樣本數據,計算均值和標準差的估計值,將二者相除,畫在坐標紙上。沒有計算機,他對數百個樣本逐一計算,畫出頻率圖。這本質上就是手工版的蒙特卡洛模擬。1908年,他發表了這項成果,提出了後來被稱為t檢驗的方法。
因為吉尼斯禁止員工發表文章,他用了筆名「學生」(Student)。從此統計學文獻裡多了一個神秘的「Student先生」,直到他1937年去世,吉尼斯家族才第一次知道自己的員工在做這些工作。
戈塞特為人謙遜,常在信中寫「我的個人研究僅僅為這個問題提供了一個粗略的概念」,並澄清「所有數學基礎實際上都是費希爾完成的」。費希爾和皮爾遜是死對頭,戈塞特是唯一跟他倆都保持親密關係的人。在那個天才們互相看不起的年代,戈塞特是橋樑。
而戈塞特解決的那個問題,跟今天每一個互聯網公司面臨的困境一模一樣:你只有有限的數據,但你要對未來做判斷。你的用戶樣本只有幾百個,你要不要把新功能上線給所有人?你的A/B測試跑了三天,結果顯示B版本好一點,但這個「好一點」是真的還是噪音?你的廣告點擊率提升了2%,是演算法有效還是運氣好?
這些問題的答案,都藏在戈塞特一百年前在餐桌上畫的那些座標紙裡。
如果你覺得假設檢驗聽起來離生活太遠,那我們換一個更直觀的:相關不等於因果。
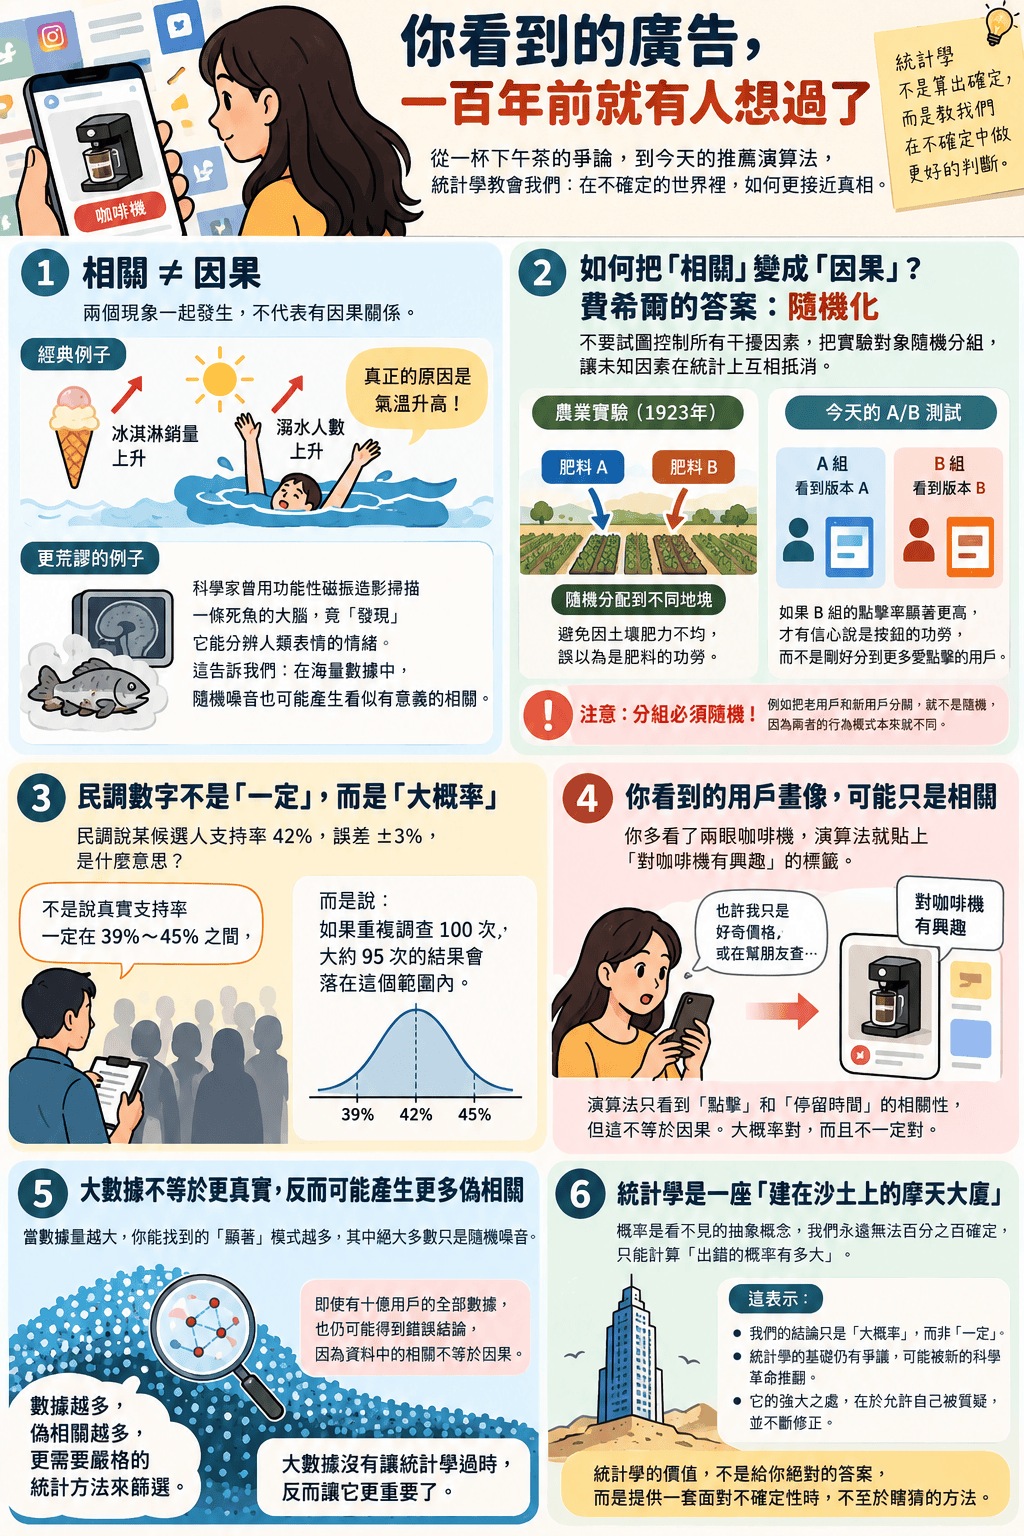
這句話你可能在很多地方聽過,但大多數人只是把它當口頭禪,並沒有真正理解它的殺傷力。皮爾遜當年就發現了大量看似相關但實際沒有內在關聯的現象,他管這叫「偽相關」。比如冰淇淋銷量上升的時候,溺水人數也上升。你如果據此禁止賣冰淇淋,溺水事故並不會減少。因為背後的真正變量是氣溫。
但「相關不等於因果」這句話的真正威力,在於它反過來也成立:很多你堅信的因果關係,可能只是相關。
2009年,加州大學一位神經學家做了一個惡作劇式的實驗。他把人類表情的照片給一條死魚看,用功能性磁振造影掃描死魚的大腦。結果「發現」死魚居然能「正確判斷」照片中人的情緒。這個實驗獲得了2012年搞笑諾貝爾獎,但它揭示的問題一點也不好笑。當你在海量數據裡反覆尋找「顯著」的關聯,隨機噪音也會產生看似有意義的模式。死魚當然不會判斷情緒,但如果你不使用嚴格的假設檢驗,你的演算法也可能從數據裡「發現」一條死魚的情緒識別能力。
今天每一個推薦演算法背後,都在做這件事:從海量數據裡找模式。你看了咖啡機的頁面,演算法記住了。但你停下來看,是因為你想買,還是因為你剛好被標題吸引了?演算法分不清。它只看到「點擊」和「停留時間」這兩個變量之間的相關性,然後據此推論你對咖啡機有興趣。這個推論對不對?大概率對。但「大概率對」和「一定對」之間的距離,就是統計學存在的意義。
那怎麼才能把「相關」變成「因果」?費希爾給出了答案:隨機化。
1923年,費希爾在洛桑農業實驗站研究不同肥料對馬鈴薯的影響。他面臨一個問題:農田肥力不均勻,東邊的土可能比西邊肥,你怎麼知道馬鈴薯長得好是因為肥料好,還是因為剛好種在肥土上?
科學家們爭論不休,越來越糾結於複雜的實驗構造。費希爾坐在椅子上靜靜抽著煙斗,等大家說完。「隨機化。」他開口了。
隨機化的本質是:不要試圖控制所有干擾因素,因為你根本不知道它們是什麼。你把不同的肥料隨機分配到不同的地塊,讓所有未知因素的影響在統計上互相抵消。你不需要知道東邊比西邊肥多少,你只需要保證「施肥A」和「施肥B」被分配到肥土和瘦土的機會一樣多。
這個思想後來主導了醫學試驗、藥物審批,以及今天互聯網公司的A/B測試。你把用戶隨機分成兩組,一組看到A版本的按鈕,一組看到B版本。如果B組的點擊率顯著高於A組,你才有信心說是按鈕的功勞,而不是因為B組剛好分到了更多愛點擊的用戶。
但你注意到了嗎?這裡有個前提:用戶必須是「隨機分組」的。很多公司的A/B測試看起來在跑實驗,實際上分組根本不隨機。比如按註冊時間分組,老用戶一組新用戶一組,這就不是隨機,因為老用戶和新用戶的行為模式本身就不一樣。費希爾一百年前就想清楚的問題,今天依然有公司在犯。
再想想民意調查。選舉期間,民調機構說「某候選人支持率42%,誤差±3%」。這個「±3%」是什麼意思?它不是說真實支持率一定在39%到45%之間,而是說「如果重複調查一百次,大約九十五次的結果會落在這個範圍內」。你看到了嗎?這就是費希爾的邏輯:你永遠不確定單次結果是否準確,你只能知道「出錯的概率有多大」。下次看到民調數字領先對手兩個百分點就宣稱「領先」的新聞,你就知道這在統計上幾乎等於打平。
還有用戶畫像。你在購物網站上多看了兩眼一款咖啡機,演算法立刻給你貼上「對咖啡機有興趣」的標籤,從此走到哪都推咖啡機廣告。但「多看了兩眼」等於「有興趣」嗎?也許你只是好奇價格,也許你手滑了,也許你在幫朋友查。演算法不管這些,它只看到點擊和停留時間的相關性,就把一個概率性的行為固化成了一個確定性的標籤。皮爾遜一百年前就警告過的「偽相關」,今天每天都在你的手機裡上演。
再往深一層想。你每天被各種「數據驅動」的決策包圍。新聞標題說「研究表明喝咖啡的人更長壽」,你的健康App告訴你「步數超過一萬步的用戶心血管風險更低」,公司報告說「使用了我們新功能的用戶留存率提升了15%」。這些結論裡,有多少是真正的因果,有多少只是相關?有多少做了隨機對照,有多少只是看了看數據就下了結論?
統計思維要你做的,是學會問一個問題:這個結論是怎麼得出來的?它背後的數據是怎麼收集的?樣本多大?分組隨機嗎?有沒有對照組?
問出這些問題的人,就是大數據時代的明白人。
但《女士品茶》這本書最讓我回味的地方,不是它講了多少統計方法,而是它在最後坦坦蕩蕩地承認:統計學可能是一座建在沙土上的摩天大廈。
這聽起來有點嚇人。統計方法不是已經席捲了所有學科嗎?從醫學到農業,從經濟學到心理學,假設檢驗、回歸分析、隨機對照實驗,這些工具已經成了科研究的標準配備。統計思想在大多數領域擊敗了決定論,它的基本假設已經成了現代社會不言而喻的組成部分。一座勝利姿態的摩天大廈,怎麼會是沙土上的?
問題出在概率這個概念本身。
概率是什麼?你說擲硬幣正面朝上的概率是50%,這是什麼意思?是說硬幣「記住了」自己應該一半正面一半反面?是說宇宙裡有某種力量在維持平衡?都不是。概率是一個看不見、摸不著的抽象概念。你永遠無法「觀測」到一個概率,你只能觀測到一次又一次的具體結果。概率分布是數學模型,不是物理實體。
你擲十次硬幣,出現七次正面。你能說硬幣有問題嗎?不能。十次太少,隨機波動完全可以解釋。那擲一萬次呢?如果還是七成正面,你就有理由懷疑了。但你永遠無法百分之百確定,你只能說「正常的硬幣出現這種結果的概率極低」。你每做一次判斷,都在用概率,但概率本身你永遠看不見。
這就是統計學最根本的困境:你的一切判斷都依賴一個你永遠看不見的東西。
費希爾和皮爾遜當年就為這個問題吵過。他們爭的是一個聽起來很玄的問題:數據背後有沒有一個「真正的規律」?打個比方,皮爾遜認為地圖就是地形本身,你畫出來的分布就是真實的。費希爾認為地圖只是地圖,地形是另一回事,你看到的數據只是在幫你猜那個看不見的真實分布。據書中所述,1930年代費希爾似乎贏了這場爭論,1970年代皮爾遜的觀點又再度興起。這場爭論至今沒有定論。
而大數據時代的到來,讓這個哲學困境更加尖銳了。推論統計學的全部基礎是「用樣本估計總體」,你不可能測量所有馬鈴薯,所以你抽一批樣本,用統計方法推斷整體的分布。但今天,當你可以收集到幾乎所有用戶的點擊數據,當總體數據唾手可得,樣本和總體的界限模糊了。如果我有十億用戶的全部行為記錄,我還需要抽樣嗎?我還需要假設檢驗嗎?我還需要t分布嗎?
這是一個真實的張力。有些數據科學家確實認為,大數據時代推論統計已經過時了。你不需要從樣本推斷總體,因為你就有總體。
這聽起來像個哲學問題,但後果是實實在在的。死魚實驗就是最好的警示。數據多不等於噪音少。當你有十億條數據,你能在裡面找到的「顯著」模式只會更多,其中絕大多數是隨機噪音。數據量越大,偽相關越多,越需要嚴格的統計方法來篩選。大數據沒有讓統計學過時,反而讓它更重要了。
書的結尾這樣寫道:「雖然統計學取得了輝煌的勝利,但它腳下的根基並不穩固。在未來某個陰暗的角落,另一場科學革命可能正在蓄勢待發,隨時準備推翻統計學的統治,而這場革命的領導者現在可能就在我們中間。」
這話聽著像危言聳聽,但如果你回顧統計學的歷史,就會發現這正是它的常態。皮爾遜推翻了決定論,費希爾修正了皮爾遜,後來的統計學家又補充了費希爾。每一代人都在質疑上一代人的根基,每一場革命都為下一場革命鋪了路。統計學之所以強大,恰恰是因為它允許自己被質疑。
我讀完這本書最大的感受,跟讀之前完全不同。我本以為會看到一堆公式和定理,結果看到的是一群活生生的人。費希爾在花園裡較真一杯茶的味道,戈塞特在餐桌上手工模擬數百個樣本,皮爾遜固執地壓著費希爾的論文遲遲不發。他們有偏見、有私心、有恩怨,但他們共同做了一件事:發明了一套讓人類面對不確定性時不至於瞎猜的工具。
統計學背後是人在面對未知時的謙遜。承認你不知道,承認你的測量有誤差,承認你的結論只是「大概率」而非「一定」。然後在這份謙遜之上,用方法去逼近真相。
一百年前那群英國人在喝下午茶時吵出來的東西,到今天依然值得每個人了解。在一個被數據淹沒的時代,最稀缺的東西是分辨資訊的能力——而這種能力,一百年前就已經有人替你想過了。
這本書以故事化方式介紹統計學發展史,從費希爾、皮爾遜、戈塞特等人的軼事出發,說明假設檢驗、t檢驗與隨機化等概念如何誕生。它不講公式,而是透過人物故事讓讀者理解統計思維的本質。
A/B測試的核心邏輯源自費希爾設計的品茶實驗,透過隨機分組與樣本比較來判斷差異是否真實存在。今天網路公司做的按鈕測試、廣告成效比較,本質上都是同一套假設檢驗方法的延伸應用。
許多數據呈現的關聯其實只是巧合或受第三變量影響,例如冰淇淋銷量與溺水人數同步上升,其實是氣溫造成的偽相關。演算法若只依賴相關性下判斷,容易產生像死魚實驗那樣荒謬的錯誤結論。
雖然有人認為擁有全體數據後就不再需要抽樣推論,但實際上數據量越大,隨機噪音產生的偽相關也越多。因此嚴謹的統計方法在大數據時代不僅沒有過時,反而更加關鍵。