

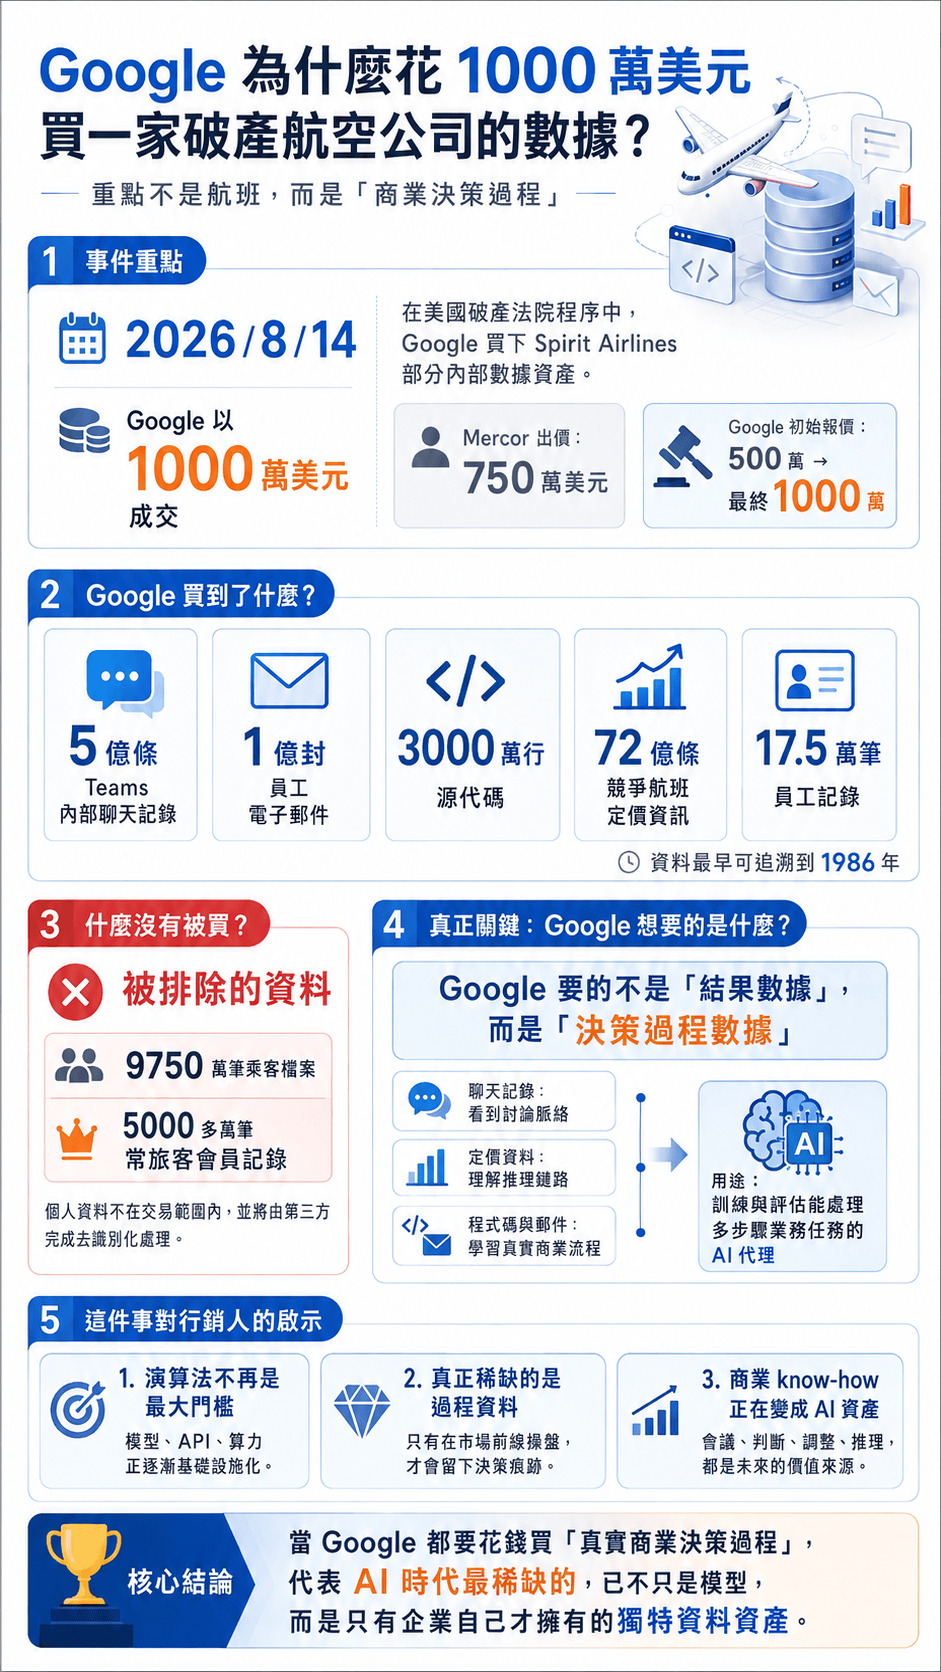
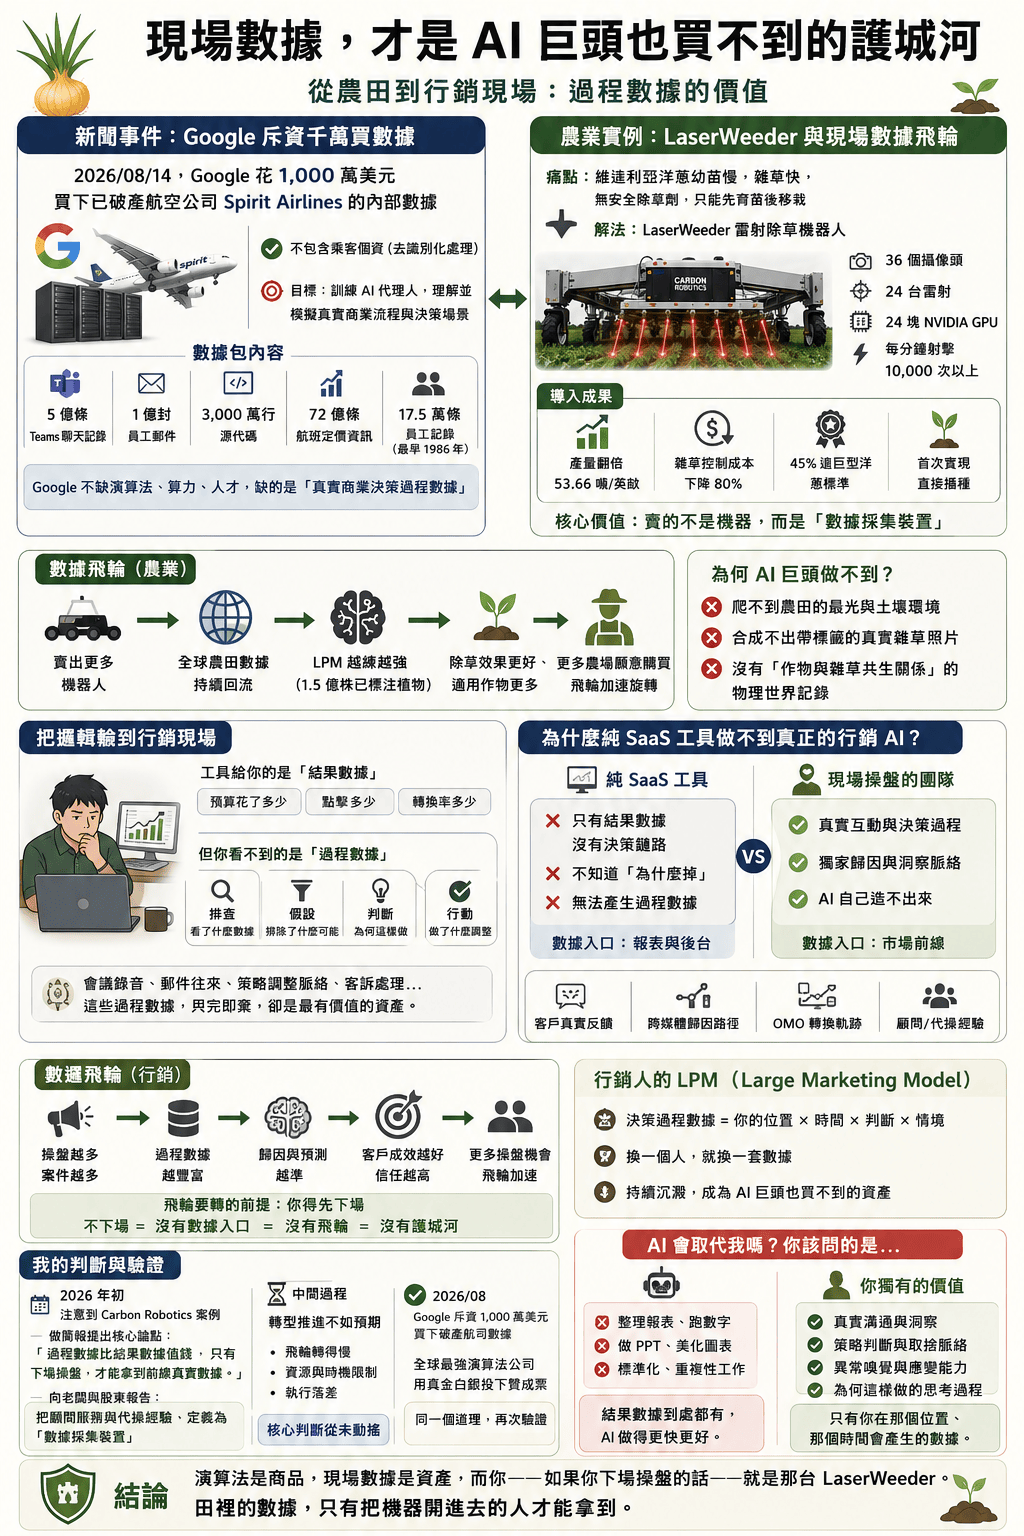
2026 年 8 月 14 日,美國紐約南區破產法院披露了一份通知,內容是:谷歌花了一千萬美元,買下了一家已經破產停飛的美國廉價航空公司 Spirit Airlines 的內部數據。
一千萬美元。將近三億新台幣。買的不是飛機,不是航線,不是商標,而是一家破產公司的伺服器裡那些東西。
你第一反應可能是:谷歌為什麼要買一家失敗公司的數據?
但這個問題問錯了方向。真正該問的是:谷歌有全世界最強的 AI 團隊,有自己研發的大模型 Gemini,有全球最龐大的算力基礎設施——它什麼都不缺,為什麼還要花錢買數據?
而且,谷歌不是唯一一個想買的。一家叫 Mercor 的 AI 公司也參與了競標,出價七百五十萬美元。谷歌最初報價五百萬,被 Mercor 加價到五百二十萬後,谷歌直接翻倍——一千萬,成交。
一家全球演算法能力最強的公司,和一家 AI 訓練數據公司,在破產法庭上搶一家廉價航空的內部數據。這幅畫面本身就值得我們停下來想一想。
谷歌買到的數據包裡有什麼?五億條 Microsoft Teams 內部聊天記錄,一億封員工電子郵件,三千萬行源代碼,七十二億條競爭航班定價資訊,還有十七萬五千條員工記錄,最早可追溯到 1986 年。
但這裡有一個細節特別值得注意:谷歌沒有買乘客個人資料。九千七百五十萬個乘客檔案、五千多萬條常旅客會員記錄——這些被明確排除在交易範圍外。美國破產法對出售消費者個人資訊有嚴格限制,谷歌也承諾所有數據在交付前由第三方完成去識別化處理。
但更關鍵的是:谷歌根本不需要乘客個人資料。它要的不是「誰坐了什麼航班」這種結果數據,而是「一家航空公司三十年來怎麼做決策」的過程數據——Teams 聊天裡的討論脈絡,定價模型背後的推理鏈路,開發團隊在代碼裡留下的思路。
谷歌在聲明中說得很清楚:這批數據將用於訓練和評估需要完成多步驟業務任務的 AI 代理,使其更好地理解和模擬真實的商業流程與決策場景。
翻譯成人話就是:谷歌的 AI 已經很會聊天了,但它還不夠會做生意。它需要真實的商業決策過程數據來學習——而這種數據,網路上爬不到,公開資料庫裡找不到,只有真正在商業前線打過仗的組織才會留下來。
谷歌自己造不出來這種數據。所以它花錢買。
這件事值得所有行銷人停下來想一想。
大眾對 AI 時代有一個直覺判斷:演算法最值錢。誰的模型最強,誰就贏。所以大家焦慮的是——我的公司沒有 Google 那種算力,我請不起頂尖的 AI 工程師,我怎麼跟得上?
但谷歌花一千萬美元買破產航司數據這件事,恰好打碎了這個直覺。
你想想:谷歌缺演算法嗎?它有 Gemini,有 DeepMind,有全世界最密集的 GPU 叢集。它缺算力嗎?它本身就是雲端運算最大的供應商之一。它缺人才嗎?全球頂尖的 AI 研究者都想進谷歌。
它什麼都不缺。但它還是要花錢買數據。
這說明什麼?說明演算法已經不是瓶頸了。演算法正在變成基礎設施——開源模型遍地都是,API 隨處可調,你花幾十美元一個月就能用上跟大廠同級別的語言模型。演算法是商品,而且是一個越來越便宜的商品。
真正稀缺的,是那些演算法吃不進去的東西——只有親身在商業現場操盤,才會留下來的過程數據。
快刀青衣在得到上講這件事時,用了一個特別精準的判斷:判斷一條數據值不值錢,其實就看一個問題——它記錄的是「發生了什麼」,還是「怎麼決定這麼做的」?前者是結果,後者是過程。
結果數據到處都是。營收數字、點擊率、轉換率、會員數——這些是「發生了什麼」。你公司的報表裡有,競爭對手的財報裡也有,行業報告裡全是。這些數據可以被總結、被發布、被爬取,它們的取得門檻很低。
但過程數據——一家航空公司的人們在 Teams 聊天裡怎麼討論一條新航線的開闢,定價團隊在模型裡怎麼權衡競爭對手的價格變化,工程師在代碼裡留下了什麼樣的決策假設——這些東西,只有在真實的商業運營中才會產生,只有真正下場操盤的組織才會累積。
快刀青衣還打了一個比方:你想想高中裡兩個學霸,每天上的課一樣,用的教材一樣,老師講的也一樣,但最後成績就是有差距。差在哪?可能一個學霸有個一對一的輔導老師,另一個學霸手裡有師兄留下來的獨門手寫筆記。公開語料就是那本教材,大家都有,拉不開差距。真正拉開差距的,是你抽屜裡那本別人沒有的東西。
谷歌買的,就是 Spirit Airlines 抽屜裡那本別人沒有的筆記。
而且谷歌不是唯一一個在這麼做的。Anthropic——Claude 背後的公司——搞了一個「巴拿馬計畫」:大量收購實體書,運到倉庫逐頁拆開掃描數位化,掃描完直接銷毀紙本。為什麼?因為它要的是 2022 年之前、未被 AI 生成內容污染過的純人類作品。越偏門的專業書籍越受歡迎——偏門意味著沒人掃過,沒人掃過意味著獨家。
國內也有類似的案例。上海庫帕思科技發現,醫生的判斷邏輯在結構化病歷裡體現不出來——表單上寫著「診斷:高血壓,處方:A 藥」,這是結果;但醫生為什麼排除了 B 藥、為什麼在這個劑量上猶豫,這些思考過程只有用敘事的方式才能還原。他們乾脆把結構化病歷反向轉成敘事語料,跟谷歌買航司數據的邏輯一模一樣:要的是「怎麼思考」的鏈路,不是「結論是什麼」的表單。
所以你看,從谷歌到 Anthropic 到庫帕思,最聰明的 AI 公司都在做同一件事:想盡辦法獲取那些只有下場操盤才會產生的過程數據。
這就引出了一個對行銷人至關重要的判斷:如果你的工作只是整理報表、跑報告、看結果數據,那 AI 遲早能替代你,因為結果數據到處都是。但如果你在行銷現場留下了決策過程的痕跡——為什麼選這個管道而非那個、為什麼這次活動的預算這樣分配、為什麼這個客戶的轉換路徑跟預期不同——這些東西,是 AI 自己造不出來的。
問題是,大多數行銷人根本沒有意識到自己在產生這種數據,更沒有想過要把它沉澱下來。
要理解「現場數據為什麼是 AI 巨頭也拿不到的護城河」,我們得先離開辦公室,去看一個跟行銷八竿子打不著的行業——農業。去一片洋蔥田裡看看。
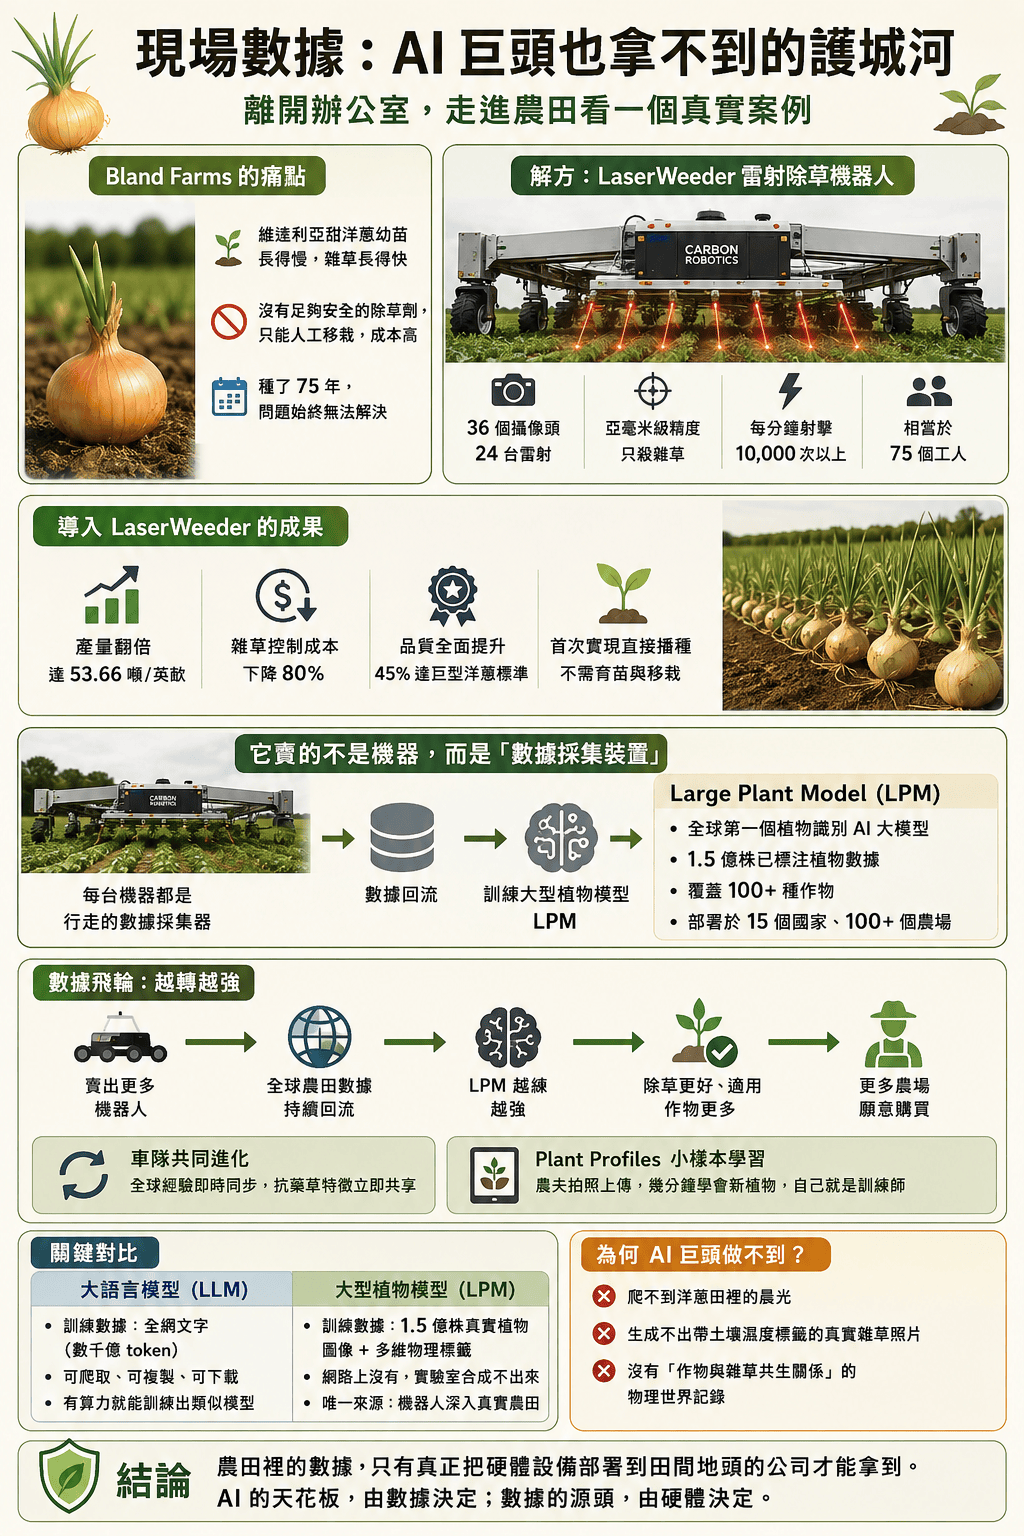
美國佐治亞州,有一個叫 Bland Farms 的農場,種了七十五年的維達利亞甜洋蔥。這種洋蔥辛辣度極低、甜度很高、口感脆嫩,可以直接生吃,是佐治亞州的地標農產品。
但種這種洋蔥有一個要命的痛點:幼苗長得太慢,雜草長得太快。而且沒有對洋蔥足夠安全的化學除草劑——你噴了除草劑,雜草死了,洋蔥也跟著傷了。所以整個地區的洋蔥種植戶只能用一種笨辦法:先在溫室育苗,等幼苗長到足夠強壯,再人工移栽到田裡。這種方式成本高、耗人工,而且限制了經營效率。
Bland Farms 種了七十五年洋蔥,七十五年都沒有解決這個問題。
直到 2018 年,一個叫 Paul Mikesell 的人在西雅圖創辦了一家叫 Carbon Robotics 的公司。這個人的背景很有意思——他大學畢業後聯合創辦了一家數據存儲公司 Isilon Systems,2010 年以二十二點五億美元賣掉。之後他在 Uber 和 Facebook 當工程師。一個網路世界的老手,突然轉頭去做農業機器人。
他做出來的東西叫 LaserWeeder——雷射除草機器人。
這台機器的配置聽起來像一輛超級跑車:二十四台高功率雷射發射器,三十六個攝像頭,二十四塊 NVIDIA GPU。機身跨度六公尺多,每分鐘射擊一萬次以上。一台全速運轉的 LaserWeeder,相當於七十五個工人的工作量。
但這台機器真正厲害的地方,不是它除草有多快,而是它除草的方式。
雷射打的是雜草的生長點——植物維持生長的核心細胞。AI 模型即時處理攝像頭傳回的圖像,識別出哪株是雜草、哪株是作物,然後雷射在幾毫秒內燒毀雜草的生長點。精度達到亞毫米級——哪怕雜草緊貼著作物幼苗,也能精準剔除,不傷作物分毫。
而且雷射完全不接觸地面,不會翻動土壤,也就不會驚醒深處沉睡的雜草種子。化學除草劑會催生具有抗藥性的「超級雜草」,但物理燒毀是降維打擊——雜草沒法對雷射進化出抗性。
Bland Farms 引入 LaserWeeder 之後,發生了一件歷史性的事:他們第一次實現了維達利亞洋蔥的直接播種。不需要再先育苗後移栽了——因為機器人可以在幼苗和雜草並存的田裡,精準地只殺雜草。
結果呢?產量翻了一倍,達到每英畝五十三點六六噸。雜草控制成本下降了百分之八十。而且洋蔥品質全面提升——球莖更大、硬度更高、保質期更長,其中百分之四十五達到了最高經濟價值的巨型洋蔥標準。
但故事到這裡才剛剛開始。
你以為 Carbon Robotics 賣的是除草機器人?不。它賣的是一台數據採集裝置,除草只是這台裝置的副產品。
每一台賣出去的 LaserWeeder,都是一個行走的數據採集器。三十六個攝像頭在田裡每秒拍下無數張照片,每一張照片都帶著 GPS 座標、光照條件、土壤類型、作物生長階段等多維標籤。每一次雷射擊發,都相當於給 AI 模型提供一個訓練樣本——這是雜草,應該消滅;這是作物,應該保護。
這些數據回傳到中央系統,訓練出一個東西——Large Plant Model,大型植物模型,簡稱 LPM。
LPM 是全球第一個專注於植物識別的 AI 大模型。它的訓練數據量是多少?一點五億株已標注的植物數據。覆蓋一百多種作物。部署在十五個國家、一百多個農場。
這裡有一個關鍵的對比,值得你想清楚。
大語言模型——LLM——的訓練數據是什麼?是全網的文字。幾千億個 token。這些數據可以爬取、可以複製、可以下載。你今天訓練了一個語言模型,別人只要有足夠的算力,理論上可以用同樣的數據訓練出一個差不多的。
但 LPM 的訓練數據是什麼?是一點五億株真實植物的高清圖像,每一張都帶著多維物理標籤。這些數據,網路上沒有,爬蟲抓不到,實驗室裡合成不出來。唯一的取得方式,就是把機器人開到真實的農田裡,讓它在真實的陽光、真實的土壤、真實的雜草叢生中,一張一張地拍。
這就是 Carbon Robotics 的數據飛輪。
飛輪的邏輯是這樣的:賣出更多機器人 → 全球農田數據持續回流 → LPM 越練越強 → 除草效果更好、適用作物更多 → 更多農場願意購買 → 飛輪加速旋轉。
而且這個飛輪有一個加速器:車隊共同進化。一台在澳洲遇到抗藥性雜草後學到的特徵數據,能立刻同步給蘇格蘭和美國加州的機器人。全世界每一台 LaserWeeder 的經驗,都是全體機器人的經驗。
還有一個更精妙的設計。農夫在 iPad 上有一個叫 Plant Profiles 的功能——碰到沒見過的植物,拍兩三張照片上傳,系統幾分鐘內學會識別,機器人立刻知道該打還是該保。不需要技術背景,農夫自己就是模型訓練師。這本質上是小樣本學習在物理世界的應用。
Carbon Robotics 的 CEO Paul Mikesell 說過一句話:「就像人類看到從未見過的生物,也能根據外形和位置判斷它是不是雜草。」
LPM 已經強到什麼程度?它甚至能推斷出它從未見過的植物品種及其構造。一百多個農場持續餵養它,一點五億個標籤數據讓它不是在「記住」植物,而是在「理解」植物。
那問題來了:谷歌、OpenAI、Meta 這些 AI 巨頭,為什麼不做一個 LPM?
不是技術不行。是場景不在他們的射程內。
谷歌可以爬遍全網,但爬不到洋蔥田裡的晨光。OpenAI 能生成逼真圖像,但造不出帶土壤濕度標籤的真實雜草照片。Meta 有幾十億用戶的行為數據,但沒有「作物與雜草共生關係」的物理世界記錄。
AI 的天花板,由數據決定。而數據的源頭,由硬體決定。Carbon Robotics 從 2018 年起就把機器人開進農田,七年深耕換來別人無法複製的數據護城河。
農田裡的數據,只有真正把硬體設備部署到田間地頭的公司才能拿到。
現在把這個邏輯從農田搬進行銷現場。
行銷人面臨的處境,跟 Bland Farms 種洋蔥的農夫其實沒什麼兩樣。你的痛點不是「沒有工具」——市面上 SaaS 工具多到眼花撩亂,成效廣告平台、CRM 系統、數據看板、行銷自動化軟體,一應俱全。你的痛點是:這些工具給你報表,但報表是結果,不是過程。
你打開後台,看到的是:這個管道上週花了多少預算,帶來多少點擊,轉換率是多少。這些是「發生了什麼」。
但你看不到的是——比如今天早上你打開後台,發現成效廣告的 ROAS 昨天突然掉了百分之二十。你開始排查:是素材疲勞了?是競品昨天調了出價?還是某個管道的流量突然變了質?你調出數據看了半小時,最後發現是週末一檔綜藝節目的收視群跟你的目標受眾重疊,節目結束後那批流量湧進來,點擊很多但根本不轉換。於是你調整了受眾標籤,把那批流量排除掉,ROAS 回升了。
這整個排查過程——你看了什麼數據、排除了什麼假設、最後做了什麼判斷——就是行銷現場的「過程數據」。但大多數時候,這個過程只存在於你的腦子裡,用完即棄。
而這些「為什麼」的答案,不在任何一個 SaaS 工具的報表裡。它們藏在行銷人每天的決策過程中——在跟客戶溝通的會議錄音裡,在跨部門協調的郵件裡,在調整投放策略時的思考脈絡裡,在處理客訴時的判斷邏輯裡。跟谷歌買的 Spirit Airlines 的 Teams 聊天記錄和定價模型,本質上是同一種東西。
問題在於,大多數行銷人把這些東西當成「工作的副產品」,用完即棄。會議開完了,錄音刪了。活動跑完了,調整過程沒記錄。客戶流失了,事後分析寫個結論就交差了。
但 Carbon Robotics 的做法告訴我們:除草是副產品,數據才是主產品。每一次雷射擊發,都是一個訓練樣本。
同樣的道理:每一次行銷決策,每一次預算調整,每一次客戶互動,都是一個訓練樣本。問題是你有沒有把它沉澱下來。
純軟體 SaaS 工具為什麼做不到真正的行銷 AI?因為它只有結果數據,沒有過程數據。它能告訴你「轉換率掉了百分之十五」,但它不知道「為什麼掉」。它沒有決策鏈路,沒有思考脈絡,沒有那些只有下場操盤才會留下的痕跡。
這不是工具不夠好的問題,是數據入口的問題。
LaserWeeder 的數據入口在實體機器裡——攝像頭拍到的真實農田。行銷 AI 的數據入口在哪裡?在行銷人每天跟市場的互動裡——在客戶的真實反饋裡,在跨媒體投放的歸因路徑裡,在 OMO 全通路轉換的真實軌跡裡,在顧問服務和代操經驗的積累裡。
這些數據,爬蟲抓不到,公開資料庫裡沒有,SaaS 工具自己產生不出來。只有真正在市場前線持續操盤的團隊,才會一點一滴地累積出來。
而且這個累積有飛輪效應——跟 Carbon Robotics 的飛輪一模一樣。你操盤越多,過程數據越豐富 → 數據回饋到模型裡,歸因和預測越準 → 客戶成效越好,吸引更多操盤機會 → 更多操盤帶來更多數據 → 飛輪加速。
但飛輪要轉起來,有一個前提:你得先下場。
你不能站在場邊看別人操盤,然後想著「我買個工具就能得到一樣的數據」。這就像你想做 LPM,但不願意把機器人開到田裡去——那你的模型永遠不會有真實農田的數據。
行銷領域的 LPM,注定誕生在每天跟市場前線打交道的人手裡,不會誕生在只看報表的人手裡。
說起來,這個判斷不是我看到谷歌買數據的新聞之後才有的。
今年年初,我就已經形成了這個認知。當時我注意到 Carbon Robotics 的案例,立刻被一個東西擊中了:不是雷射除草的技術多酷,而是他們對「數據」這個詞的理解,跟一般人不一樣。
一般人說數據,想的是報表、是儀表板、是 KPI 數字。Carbon Robotics 說數據,想的是「只有我的機器人在真實農田裡才拍得到的那些東西」。前者是結果,後者是過程。前者人人都有,後者只此一家。
這個區別太關鍵了。
當時我做了一份簡報,拿 Carbon Robotics 當案例,核心論點就一句話:在 AI 時代,數據是一切的基礎,而最有價值的數據,只有下場操盤才拿得到。我把這個邏輯從農業映射到行銷——真正的行銷 AI,不可能靠爬蟲或純 SaaS 工具做出來,只有「下場操盤」的團隊才能拿到前線真實的轉換數據。我把顧問服務、代操經驗、跨媒體整合這些日常工作,重新定義為「數據採集裝置」——就像 LaserWeeder 是 Carbon Robotics 的數據採集裝置一樣。
這份簡報我拿去跟老闆和股東報告過。報告的時候,我指著 Carbon Robotics 的飛輪圖,跟他們說:我們的顧問服務和代操經驗就是這台 LaserWeeder,每一個客戶案子的操盤過程就是數據採集,只要把過程沉澱下來,我們就能做出別人做不出的行銷 AI。
老闆聽完沒有馬上反對,但也沒有馬上支持。他問了一個很實際的問題:這個飛輪轉一圈要多久?
坦白說,公司原本期待的轉型沒有完全實現。有些東西你想到了,不等於組織能跟上。飛輪轉得太慢,中途有人失去了耐心,資源被挪去了別的方向。這中間有執行的落差、有資源的限制、有時機的問題,這些都很正常。
但核心判斷我沒有動搖過。
然後半年後,2026 年 8 月,谷歌花了一千萬美元買下一家破產航空公司的內部數據。
全球演算法能力最強的公司,用真金白銀投了贊成票。
你說這算不算驗證?我覺得算。這不是事後諸葛亮——年初的時候判斷已經形成了,簡報已經做了,論點已經講過了。谷歌只是用一個所有人都看得見的動作,把同一個道理又講了一遍。
而且谷歌做的事比我想的更極端。我不只是說「過程數據比結果數據值錢」——谷歌直接跳過了乘客個人資料,只要決策過程數據。它比大多數人更清楚:什麼東西是它自己造不出來的。
這讓我更確信一件事:你在一線打仗時留下的決策痕跡,就是你的護城河。不是因為你多聰明,而是因為這些痕跡只有你在那個位置、在那個時間、做那些判斷時才會產生。換一個人就換一套數據。
這也是為什麼,即使公司期待的轉型沒有走通,我還是維持這個核心精神。因為判斷是對的,只是路還沒走到。換一條路走,這個判斷依然成立。
所以回到行銷人最焦慮的那個問題:AI 會不會取代我?
我認為這個問題問錯了。
真正該問的是:你每天的工作,是在產生只有你能產生的數據,還是在做一些 AI 也能做的事?
如果你的工作是整理報表、跑數字、做好看的 PPT——對不起,這些 AI 都能做,而且做得比你快。結果數據到處都是,AI 不需要你幫它找。
但如果你的工作包含這些東西:跟客戶的真實溝通,跨部門的資源協調,投放策略的即時判斷,市場異常的敏銳嗅覺,還有那些「為什麼這樣做而不那樣做」的決策脈絡——這些是只有你在那個位置、那個時間、面對那些具體的人時才會產生的過程數據。AI 自己造不出來。
谷歌用一千萬美元告訴你這種數據值多少錢。Carbon Robotics 用七年農田深耕告訴你這種數據怎麼累積。
所以停止跟 AI 對抗吧。對抗的心態浪費精力,也浪費時間。你該做的是想清楚一個判斷:哪些事情,如果不靠我親自下場,AI 永遠拿不到這個數據?
找到那些事,然後把過程沉澱下來。每一次決策都是一個訓練樣本,每一次互動都是一筆獨家數據。你不只是在做事,你是在累積一種 AI 巨頭也買不到的資產。
這不是反內卷的雞湯,這是一個判斷框架:演算法是商品,現場數據是資產,而你——如果你下場操盤的話——就是那台 LaserWeeder。
田裡的數據,只有把機器開進去的人才能拿到。
Google並非缺乏演算法或算力,而是缺少真實商業決策的過程數據。這類數據記錄了組織如何思考與判斷,而非單純的結果數字,是訓練AI代理理解真實商業情境的關鍵素材。
結果數據記錄「發生了什麼」,例如營收、點擊率等,取得門檻低且容易被公開取得。過程數據則記錄「為什麼這樣決定」,只存在於實際操盤者的決策脈絡中,難以被複製或爬取。
LaserWeeder表面上是除草機器人,實際上是一台持續採集農田真實數據的裝置,用來訓練專屬的植物辨識模型。這個邏輯套用到行銷上,代表顧問服務與代操經驗才是累積獨家行銷數據的關鍵管道。
與其擔心被取代,行銷人應思考自己的工作是否只是產出結果數據;若工作包含決策脈絡與現場判斷,這些過程若能被記錄下來,就會成為AI無法複製的獨特資產。