

范蠡大模型在魚塘邊蹲了三十年
前二十七年沒人覺得值錢,AI 來了突然變成壁壘
第一段
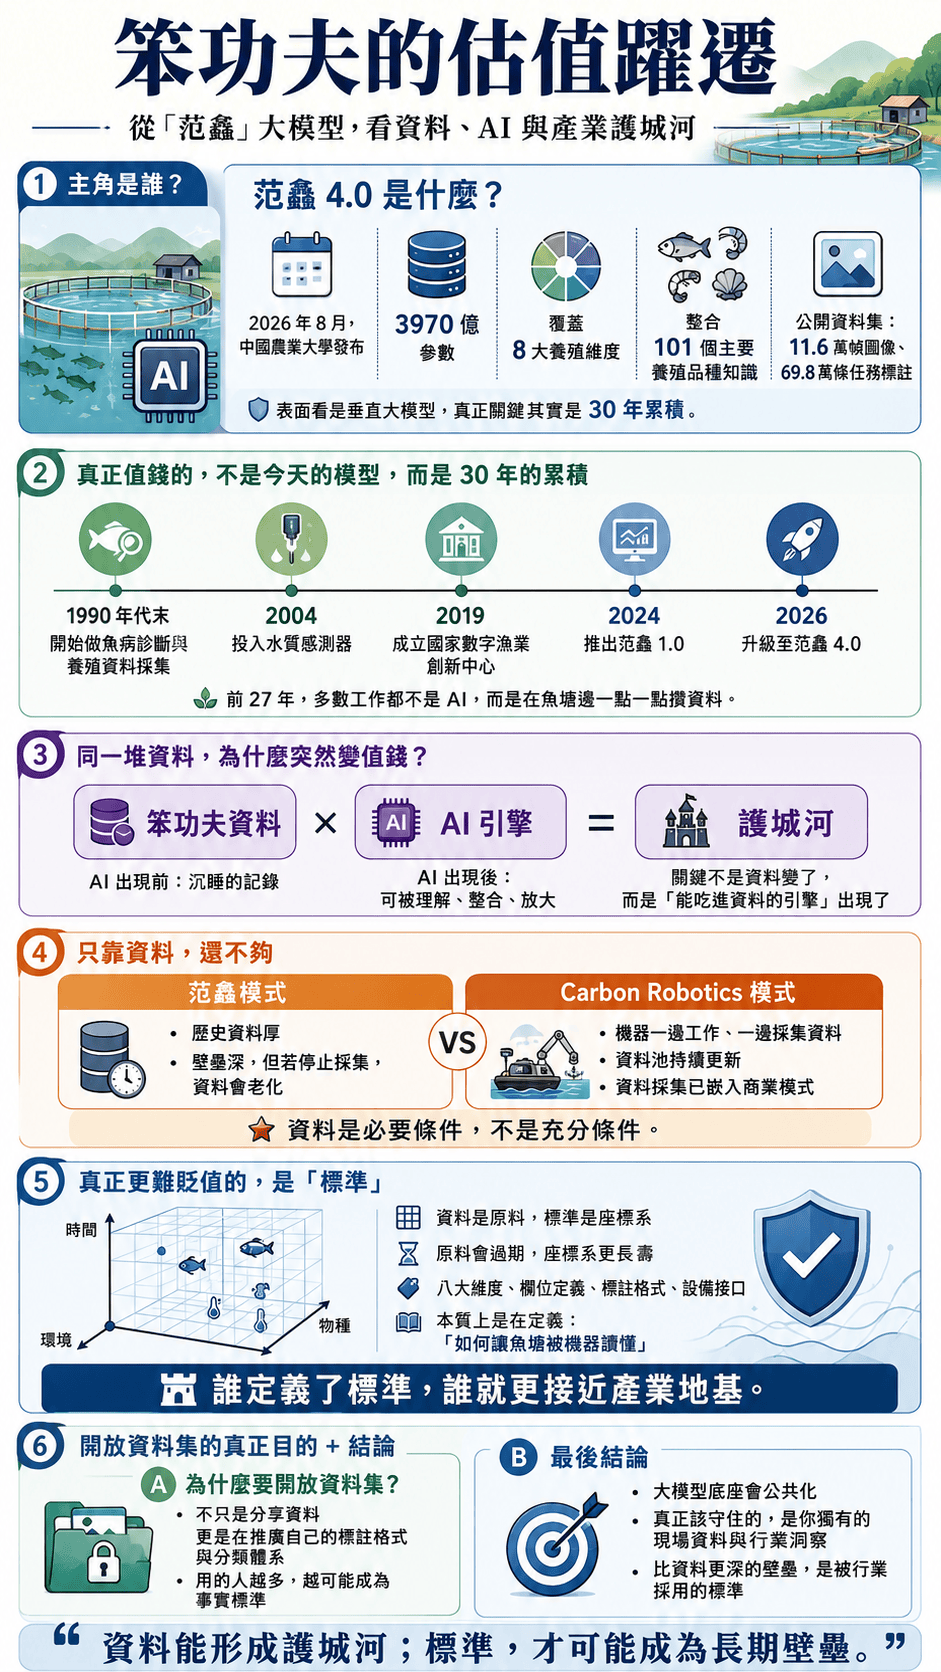
2026 年 8 月,中國農業大學發布了一個叫「范蠡」的大模型,版本號 4.0,參數規模 3970 億。
覆蓋八個養殖維度——水質、品種、飼料、健康、運營、裝備、能源、經濟。整合了 101 個主要養殖品種的知識。配套的公開數據集有 11.6 萬幀圖像、69.8 萬條任務標註。
你看到這些數字,可能會想:又一個垂直大模型,又是「AI 賦能傳統產業」的故事。
但這個故事真正值得注意的地方,不在參數規模,不在覆蓋維度,甚至不在 AI 本身。而在一個時間跨度——三十年。
范蠡大模型背後的團隊,是中國農業大學國家數字漁業創新中心主任李道亮率領的研究組。這個團隊做養殖數據的採集和研究,從上世紀九十年代末就開始了。最早做的是魚病診斷專家系統——那時候沒有深度學習,沒有 GPU 叢集,連「大模型」這個詞都還不存在。他們用的是最笨的辦法:到魚塘邊去,一條魚一條魚地記錄,一個塘一個塘地採樣。
2004 年,他們開始往硬體走,做水質傳感器。2019 年成立國家數字漁業創新中心。2024 年推出范蠡 1.0。2026 年,范蠡 4.0。
你把這條時間線拉開來看,會發現一件事:前二十七年,這個團隊做的事情,跟 AI 沒有半點關係。他們就是在魚塘邊,用最笨的辦法,一點一點地攢數據。
沒人覺得那些魚塘記錄值錢。
然後 AI 來了。
三十年攢下來的東西,突然能被大模型吃進去、能融會貫通了。那些一條一條記錄的魚病數據、一個塘一個塘採的水質參數、一年一年積累的養殖經驗——這些東西在 AI 出現之前,就是一堆沉睡的記錄。但 AI 引擎接上之後,它們突然變成了 3970 億參數的垂直大模型,變成了覆蓋八大維度、101 個品種的行業知識基座。
同一堆數據。同一個團隊。同一種笨功夫。
AI 之前,一文不值。
AI 之後,護城河。
這種事不只發生在魚塘邊。你手裡那些做了很多年、一直沒覺得值錢的積累,可能正站在同樣的臨界點上。
這就是我說的「笨功夫的估值躍遷」。
快刀青衣在得到上講范蠡大模型時,說了一句特別到位的判斷:「你的核心競爭力是三十年的養殖數據和行業洞察,那你就應該把錢和精力全砸在這上面。底座這種通用能力,市面上有強大又免費的,拿來用就好了。」
翻譯成人話就是:大模型底座是公共設施,誰都能用。你真正該守住的,是只有你才有的那些東西。
但這裡有一個更深的問題,值得我們停下來想一想。
為什麼同一堆數據,在 AI 出現之前幾乎一文不值,AI 出現之後突然變成了別人搬不走的護城河?
不是數據變了。數據還是那些數據,魚塘還是那些魚塘,記錄還是那些記錄。變的是什麼?是「能吃進這些數據的引擎」出現了。
這就像你手裡一直攥著一堆原礦石,在冶煉技術出現之前,它就是一堆石頭。但一旦冶煉技術成熟,同樣的石頭突然變成了金屬、變成了工具、變成了武器。
數據從來都在那裡。但只有當 AI 這台引擎出現,能把笨功夫攢下來的東西吃進去、消化掉、融會貫通的時候,它才從「沉睡的記錄」變成了「壁壘」。
護城河不是數據本身。
護城河是「數據+能把它吃進去的 AI」的組合。
第二段
但你要是停在這裡,就會犯一個新版本的錯誤。
你可能覺得,既然演算法是商品、數據才是資產,那只要有數據就安全了。但這個推論有個漏洞——
因為數據也會貶值。
范蠡團隊三十年攢下來的數據,今天值錢,是因為今天的 AI 剛好能吃進去。但十年後呢?二十年後呢?今天的 11.6 萬幀圖像、69.8 萬條任務標註,在下一代模型眼裡可能就像我們現在看九十年代的軟碟——有東西,但格式太老,讀起來費勁。
這不是危言聳聽。你想,Carbon Robotics 造了一台叫 LaserWeeder 的農田雷射除草機,開進田裡一邊除草一邊採數據。它真正值錢的不是那台機器,而是機器開進去之後採到的田裡數據——每一株植物的形態、位置、生長狀態。
Carbon Robotics 和范蠡,一個是硬體先行、採數據在後;一個是數據先行、等 AI 引擎在後。殊途同歸——都是「現場數據+AI 處理能力」的組合。但這兩個案例放在一起看,你會發現一個微妙的差異。
Carbon Robotics 的數據是機器自動採的——一台 LaserWeeder 開進田裡,幾十個攝影鏡頭邊幹活邊採數據。每一台賣出去的機器都是一個行走的數據採集器,全球車隊共同進化——澳洲一台機器人學到的特徵,能立刻同步給蘇格蘭和加州的機器人。它的數據池是活的,每天都在長。除草是副產品,數據才是主產品。數據採集和業務運營是同一件事。
范蠡的數據呢?三十年攢的,確實厚。但其中很大一部分是歷史記錄——過去的魚病診斷、過去的水質參數、過去的養殖經驗。這些東西不會自己更新。魚塘裡的魚在長,水質在變,新的品種在引入,新的飼料配方在出現。如果數據池不跟著長,今天的壁壘明天就會被侵蝕。
你看,Carbon Robotics 的聰明之處在於:它不是先攢夠數據再建模型,而是把機器賣出去,讓機器一邊幹活一邊採數據。它的笨功夫和 AI 引擎是同時轉的。
范蠡的笨功夫和 AI 引擎是分開轉的。前二十七年只有笨功夫,沒有引擎。引擎接上之後,笨功夫的價值才被釋放出來。但這也意味著,如果今天停止採集,范蠡的數據池就會開始老化——它不像 Carbon Robotics 那樣,數據採集已經嵌入了商業模式裡,想停都停不了。
所以「笨功夫攢下來的數據」是護城河,但不是終極護城河。它是必要條件,不是充分條件。
真正不會貶值的,
比數據更深一層的東西,是什麼?
第三段
刀哥在講范蠡大模型時,給了一個我認為特別精準的判斷:真正更難貶值的,是比數據更底層的一樣東西——那套讓魚塘能被機器讀懂的標準。
翻譯成人話就是:數據是原料,標準是座標系。原料會過期,但座標系不會。
這話聽起來抽象,我們拆開來看。范蠡大模型覆蓋八大維度——水質、品種、飼料、健康、運營、裝備、能源、經濟。你可能覺得這就是個分類目錄,沒什麼了不起。但這八個維度不是 AI 來了之後才分的。它是李道亮團隊在三十年的研究過程中,一個一個摸出來的分類框架。
什麼叫溶氧?單位是什麼?多久採一次?什麼範圍算正常?什麼範圍算魚要出事?一條魚健不健康用哪幾個字段描述?一台投餵機按什麼接口、什麼格式把數據傳上來?
這些定義,全部得有人先做。
李道亮團隊從 2004 年就開始搞水質傳感器。他們的學術論文顯示,長期聚焦的就是「如何把魚塘裡的物理現象變成機器能讀的數據」——水溫、pH 值、溶氧、電導率、氧化還原電位,每一個參數的定義、採集精度、傳輸格式,都得從零開始定。這就是刀哥說的「讓魚塘能被機器讀懂的標準」的學術基礎。
而范蠡 1.0 發布時,李道亮介紹了四個模組:「請問我」「請聽我」「請看我」「請決策」。你仔細看這四個模組——它本質上就是一套漁業數據的分類標準,把不同類型的數據分進不同模組,全有定義。
到了 4.0,這套標準更完整了。八大維度、101 個品種,構成了刀哥所說的「業內最完整的垂直領域知識圖譜」。
但最精妙的一步,是公開數據集。
范蠡 4.0 發布時,配套開放了 11.6 萬幀圖像、69.8 萬條任務標註,向全球研究機構和企業開放,歡迎使用、評估、共建、共享。
你以為這是慈善?不。這是標準推廣策略。
別人要用你的數據,就得接受你的標註格式、你的分類體系、你的欄位定義。用的人越多,你的標準就越像「事實標準」。一旦全行業的魚塘、投餵機、增氧機都按你這套標準來接、來傳數據,你就成了這個行業的地基。後來者哪怕模型比你強,也得先接入你的標準,才能跟這個行業對話。
傳感器會越來越便宜,
通用底座會越來越強。
真正難以替代的,
是誰定義了這套座標系。
有人說「過程數據是資產」——你在現場看到的、摸到的、記錄下來的,比最終結果值錢。這話對,但可以再往前推一步:過程數據確實是資產,但定義數據格式的標準才是底座。數據是內容,標準是容器。內容會更新、會過期,但容器一旦被行業接受,就很難被替換。
這跟 USB 接口一個道理——不是技術最先進,而是被最多設備採用。標準的壁壘不在技術領先,而在生態黏性。
范蠡的三十年,不只是攢了數據,更是定義了一套讓魚塘能被機器讀懂的座標系。數據可以貶值,但座標系一旦被行業接受,就是長期的壁壘。

第四段
講到這裡,范蠡故事裡最精妙的一層才浮出來。
你看,李道亮團隊有沒有自己去從頭訓練一個通用大模型底座?沒有。刀哥判斷,范蠡 4.0 的 3970 億參數,跟阿里 Qwen3.5 的 3970 億總參數精確重合——大概率是拿開源的通用大模型做底座,再疊加漁業專有數據和知識圖譜。
這不是偷懶。這是聰明。
因為底座是公共設施。阿里在投入巨資升級 Qwen,Google 在升級 Gemini,Meta 在升級 Llama——這些公司花的是幾十億、幾百億的研發經費,但開源出來,誰都能用。通用大模型每升級一次,范蠡什麼都不用干,能力就跟著漲一波。
這就是刀哥說的「復利雙輪」。
一個輪子是底座——靠外部通用技術進步,自動受益。通用大模型升級一次,你白賺一次。這個輪子不需要你花錢、不需要你出力,它自己轉。
另一個輪子是數據——靠自己的持續積累。魚塘邊上的傳感器二十四小時不停地採,三十年的行業洞察不斷往裡灌。這個輪子只有你能轉,別人轉不了。
兩個輪子,一個靠外部的通用技術進步,一個靠自己的持續積累,同時往前轉。
你看出這套邏輯的精妙之處了嗎?
底座這一頭,不構成任何護城河——因為誰都能拿開源模型。數據這一頭,才是真正的壁壘——因為只有你有。但如果你只有數據、沒有底座,數據就是一堆沉睡的記錄。如果你只有底座、沒有數據,那你就是一個空殼——模型再大,沒有行業知識餵進去,跟通用模型沒有區別。
所以范蠡的策略本質上是:把錢和精力全砸在只有自己能做的事情上(數據採集、標準定義、行業知識圖譜),把能白拿的東西全部白拿(開源底座、通用算力)。
這跟「代碼貶值,判斷升值」是同一個邏輯。
AI 越強,能寫代碼、能跑模型、能做推理的東西越來越便宜。你花十年學會的編程技巧,可能一個提示詞就替代了。但你在某個領域裡花十年積累的判斷力、行業洞察、現場經驗——這些東西,AI 反而吃不到。因為 AI 的訓練數據來自公開渠道,而你的經驗來自只有你走過的那條路。
范蠡的三十年魚塘數據,就是那條只有他們走過的路。開源底座越強,他們的數據越值錢。因為底座升級一次,能吃進去的數據就更多、更深、更細——而他們手裡的數據池,只會越攢越厚。
這才是真正的復利。不是單利,不是線性增長,是兩個輪子互相加速的復利。
第五段
講到這裡,你應該已經看出來了——范蠡的故事不只是關於漁業的。
李道亮團隊在魚塘邊蹲了三十年,前二十七年沒人覺得那些記錄值錢。但 AI 引擎接上之後,三十年的笨功夫突然變成了壁壘。這種「估值躍遷」,不是范蠡獨有的。
你手裡有沒有那種東西?
那種你做了很久、
但一直沒覺得值錢的積累?
也許是你在一個行業裡泡了十年,對這個行業的客戶心理、通路結構、價格敏感度有著教科書上找不到的理解。也許是你跑了十年業務,跟幾百個客戶打過交道,每個客戶的決策風格、每筆交易的轉折點都刻在你腦子裡。也許是你做了十年的某種手藝——設計、寫作、烹飪、教學——那些只有你才有的手感、判斷力和臨場反應。
這些東西,在 AI 出現之前,它們就是你的工作經驗。你用它們做事,但不會覺得它們是「資產」。它們沒有被結構化、沒有被數據化、沒有被系統化,所以也沒有人覺得它們值錢。
但 AI 底座越來越強。開源模型越來越大。通用能力越來越便宜。
這意味著什麼?意味著你手裡那些笨功夫,離「被激活」的臨界點越來越近了。
范蠡團隊等了二十七年才等到 AI 引擎。你不用等那麼久——引擎已經來了,而且每年都在升級。問題是,你的笨功夫有沒有被結構化?你有沒有把它從「腦子裡的經驗」變成「機器能讀的數據」?
這就是范蠡故事裡最值得注意的一個細節——李道亮團隊不是只攢了數據,他們還定義了讓魚塘能被機器讀懂的座標系。如果三十年前他們只是記錄了「今天魚塘看起來還不錯」這種模糊印象,AI 來了也吃不進去。他們之所以能接上 AI 引擎,是因為他們一開始就在用結構化的方式採集——水溫多少、pH 值多少、溶氧多少、採集時間是什麼、位置在哪裡。
你的笨功夫,是「今天魚塘看起來還不錯」,
還是「水溫 28 度、pH 值 7.2、溶氧 6.5」?
有人說過一句話:你每天在行銷現場的決策過程,就是你的數據採集——你是一台行走的 LaserWeeder。這話沒錯,但可以往前推一步。
你不只是採集器。你手裡那些笨功夫——十年的細分工作門道、一堆沒當回事的會議錄音、客戶溝通的決策脈絡、投放策略的調整邏輯——它們不只是「被採集的數據」,它們是你的范蠡時刻。
關鍵在於:你有沒有像李道亮團隊那樣,用結構化的方式把它們沉澱下來?你有沒有定義你自己的座標系——什麼欄位記錄什麼、什麼格式傳輸什麼、什麼維度歸類什麼?
如果你做到了,那麼開源底座每升級一次,你的笨功夫就增值一次。兩個輪子同時轉,復利就開始了。
如果你沒做到——如果你的經驗還只是腦子裡的模糊印象、錄音裡的閒聊、會議後的即棄記憶——那麼不管 AI 底座多強,它也吃不進去。你的笨功夫就會一直沉睡,等不到估值躍遷的那一天。
護城河不是數據本身,是數據加上能吃進它的引擎。比數據更深的,是定義座標系的標準。而最深的,是笨功夫加底座升級的復利雙輪——一個靠外部技術進步自動受益,一個靠自己的持續積累。
范蠡在魚塘邊蹲了三十年,才等到了估值躍遷的那一天。
你的范蠡時刻,什麼時候到?
指長期累積、原本不被重視的經驗或數據,在 AI 技術成熟後突然轉變成有價值的競爭壁壘。范蠡大模型的三十年養殖數據就是典型案例,過去無人在意,AI 出現後卻成為核心資產。
因為底座是公共設施,任何人都能取用免費或開源的通用大模型,例如 Qwen、Gemini、Llama。真正的競爭優勢來自只有自己擁有、別人無法複製的專屬數據與行業知識。
數據是原料,會隨時間過期或貶值;標準則是讓數據能被機器讀懂的座標系,一旦被行業廣泛採用就很難被取代。范蠡團隊定義的養殖分類與欄位規範,就是比數據本身更深層的壁壘。
關鍵在於把腦中的經驗與判斷力結構化,變成機器可讀取的紀錄,而不只是模糊印象。當這些笨功夫被系統化保存,配合持續升級的 AI 底座,就能形成自己增值的復利雙輪。